mmap か pread か — ripgrep の –no-mmap が Windows で 2.9 倍効いた理由と、改行の数え方が秒に出る/出ない境目
巨大なファイルを速く読む方法として、「mmap(メモリマップ)は速い」とよく言われます。筆者は、巨大ファイルのビューア UwView(巨大ファイルを、いつでも瞬時に)を作るなかで、この言葉に何度も引っかかりました。ripgrep の読み方を変えると Windows で 2.9 倍速くなり、自作の画面は mmap のせいで klogg に約 2 倍負けていました。逆に、速く書き直した処理が、1 秒も縮まなかったこともあります。
この記事は、その 4 つの実測を 1 本にまとめたものです。共通する答えは 1 つで、どこで詰まっているか(律速)は、OS・用途・1 回目か 2 回目かで入れ替わる、ということです。
※ファイル容量の表記について:「50GB」は 51,254,526,392 バイト(SI で 51.25GB、47.73GiB)の 1 本のファイル(OpenStreetMap 日本を XML に展開したもの)です。
先に結論
- ripgrep は、
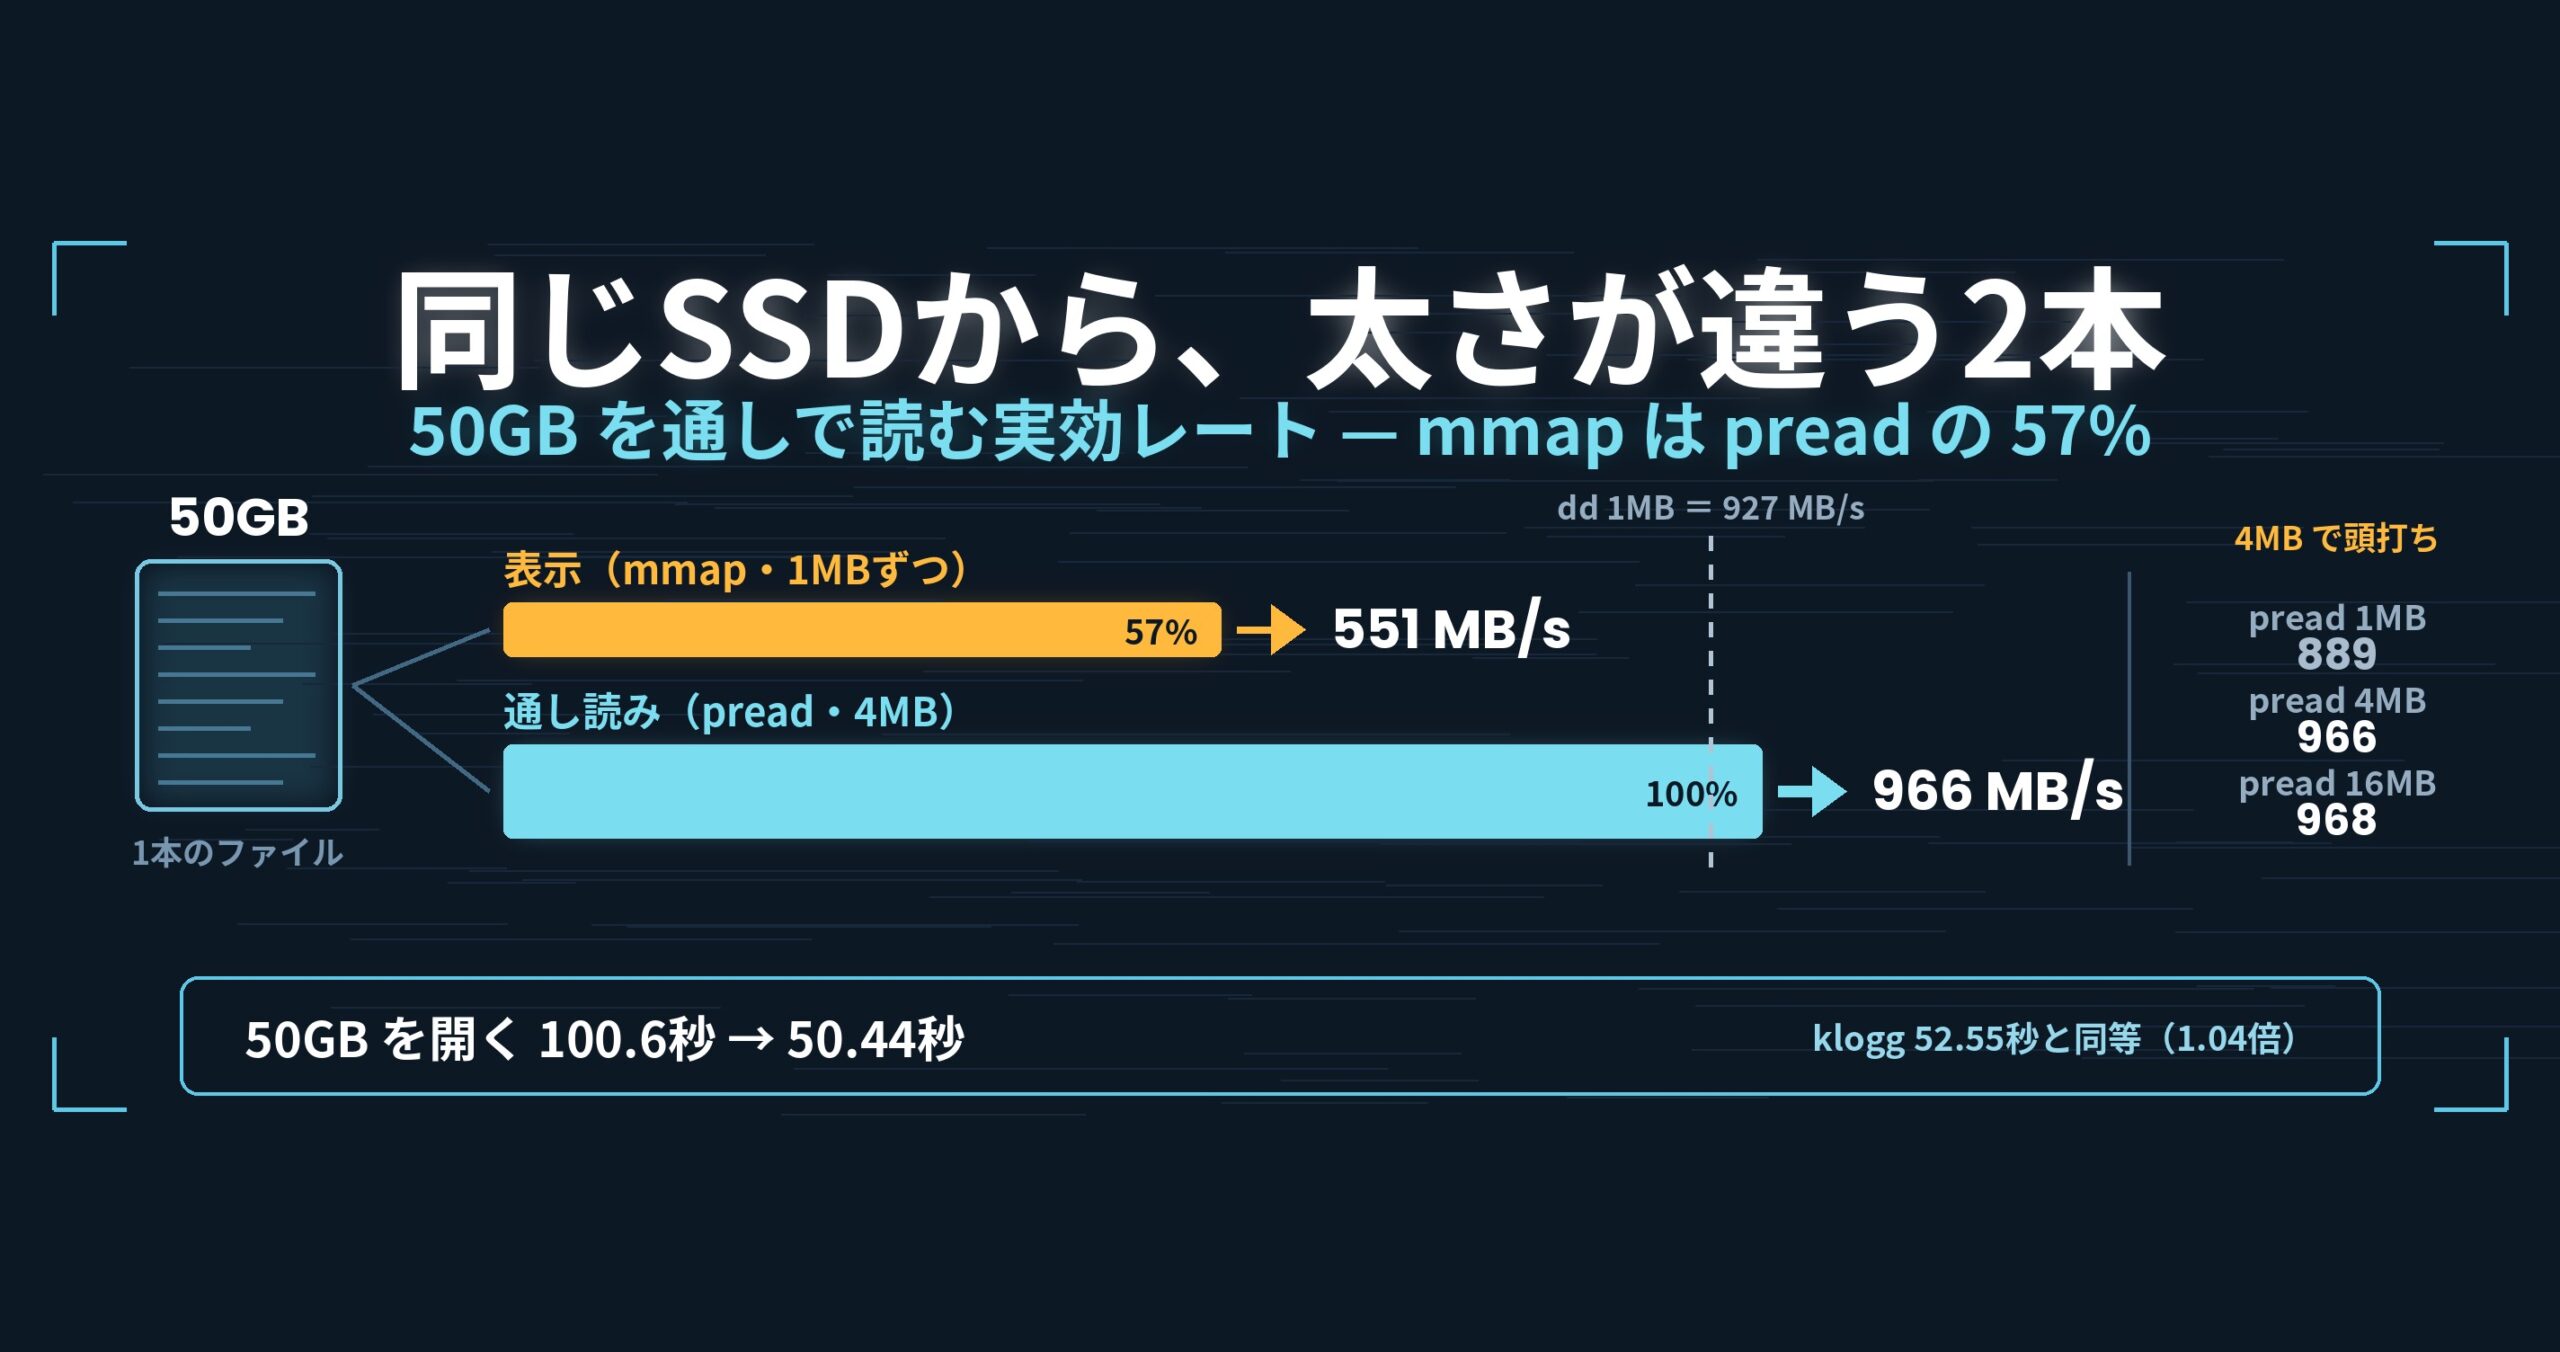
--no-mmapで速くなることがある。 50GB の 1 本のファイルで、Windows 11 の重い検索は 282.84 秒 → 97.83 秒(2.89 倍速い)。macOS は変わらず、Linux(仮想機)は検索の中身で逆転しました。 - mmap は、順に通して読むと遅い。 自作の画面で、50GB を mmap で 1MB ずつ読むと 551MB/s、pread で 4MB ずつ読むと 966MB/s でした。mmap は pread の 57% です。表示は mmap のまま、通し読みだけ pread に分けたら、50GB を開く時間が 100.6 秒 → 50.44 秒になりました。
- ディスクから読む 1 回目は、改行の数え方を速くしても秒に出ない。 メモリ上では 1.88 倍速くなったのに、50GB の実測は 968MB/s と 969MB/s で同じでした。
- 2 回目(ページキャッシュから読む)は、改行の数え方が秒に出る。 3GB で検索全体の 4 割が改行を数える時間でした。数え方を 5 倍速くして、3GB の 2 回目が 0.40 秒 → 0.27 秒(ripgrep 0.29 秒)になりました。
1. ripgrep の –mmap と –no-mmap(50GB・3 つの OS)
同じ 50GB のファイルに、同じ 2 種類の検索をかけました。すべて、キャッシュを捨てて 10 秒待った直後(cold)の値です。
- 検索 1(固定文字列):
rg -n -F '東京' <file>(ヒット 94,979 行) - 検索 2(正規表現+除外):
rg -n -v '^ +<' <file>(ヒット 3 行) - ripgrep 15.2.0(Linux のみ 15.1.0)。出力の行数が
--mmapと--no-mmapで一致することを、毎回確かめています。
| 環境 | 検索 | 既定の mmap(秒) | --no-mmap(秒) |
--no-mmap の効き目 |
|---|---|---|---|---|
| Windows 11 | 固定文字列 | 83.74 | 68.50 | 1.22 倍速い |
| Windows 11 | 正規表現+除外 | 282.84 | 97.83 | 2.89 倍速い |
| macOS | 固定文字列 | 55.38 | 55.70 | 変わらない |
| macOS | 正規表現+除外 | 59.40 | 58.47 | 変わらない |
| Linux(仮想機・メモリ 8GB) | 固定文字列 | 約 83 | 約 100 | 約 1.2 倍遅い |
| Linux(仮想機・メモリ 8GB) | 正規表現+除外 | 約 172 | 約 105 | 1.64 倍速い |
環境は、Windows 11 が HP Spectre x360(Core i7-1165G7・メモリ 15.6GB)、macOS が Apple M4(10 コア・メモリ 32GB・外付け USB SSD)、Linux がその Mac 上の VMware(仮想 2 コア・メモリ 8GB)です。秒数を環境どうしで比べないでください。 見るのは、同じ機械の中の 2 本です。
犯人は、ディスクでも CPU でもなかった
Windows で最初に疑ったのは、ファイルの断片化です。ツールを通さずに同じファイルの先頭・中ほど・末尾を読むと、1159・1134・1168MB/s で揃っていました。違います。次に、15W 級のノートの熱だれを疑いました。クロックは開始前も終了後も同じで、これも違いました。残ったのが読み方で、--no-mmap を付けた瞬間に 282.84 秒が 97.83 秒になりました。
なぜ OS で違うのか(ここからは推測です)
mmap は、ファイルをメモリのように見せ、ページに触るたびに OS がディスクから読み込む仕組みです。ファイルがメモリに収まるなら、コピーが 1 回減って効率的です。50GB は、Windows 機(15.6GB)にも Mac(32GB)にも収まりません。読んでいる間、ページの出し入れが続き、その代償が OS によって違うのだろう、というのが筆者の見立てです。測定結果から逆算した説明で、確かめてはいません。Linux で、軽い検索と重い検索で結果が逆転する理由も、説明できていません。
実用の指針
- Windows で 10GB を超える 1 本のファイルを ripgrep で探すなら、
--no-mmapを一度試す価値があります。 - macOS は、既定のままで構いません。
- Linux は、重い検索(正規表現・
-v・-iの組み合わせ)のときだけ試します。
これは ripgrep の欠陥の話ではありません。既定の mmap は、ソースツリーを探す・数 GB までのログを見る、といったふつうの使い方では正しい選択です。今回は「メモリに収まらない 1 本のファイル」という、端のほうの使い方です。
2. 自作の画面が klogg に約 2 倍負けていた原因も mmap だった
UwView の画面は、ファイルを開くときに mmap を使います。好きな場所をすぐ覗けるので、スクロールする画面には理想的です。問題は、その mmap を、索引作りと全文検索(先頭から末尾まで通しで読む処理)にも使い回していたことでした。
50GB を通しで読む実効レートを、3 巡の中央値で測りました(2026 年 9 月 20 日・Mac・外付け USB SSD)。
| 読み方 | 実効レート(MB/s) | pread+4MB を 100 としたとき(%) |
|---|---|---|
dd(媒体の素の帯域の目安・1MB) |
927 | — |
| mmap+1MB ずつ | 551 | 57 |
| pread+1MB ずつ | 889 | 92 |
| pread+4MB ずつ | 966 | 100 |
| pread+16MB ずつ | 968 | 100 |
mmap が落ちる理屈は、はっきりしています。触った瞬間にページフォルトが起き、カーネルがページを用意して、そこからコピーが入ります。通しで読むと、この往復が全部のページに 1 回ずつかかります。pread は「このオフセットから 4MB くれ」と 1 回頼むだけです。
そして、4MB で頭打ちです。16MB にしても 2MB/s しか動きません。ここで律速が媒体に移っています。並列に読んでも 960MB/s 前後で止まったので、通し読みは単線のままにしました。
改善前の検索は 550MB/s で、mmap の上限 551MB/s にぴったり張り付いていました。張り付いている処理は、探し方をどう工夫しても速くなりません。読み方を変えるしか手がありませんでした。
読み方を 2 つ持たせた
- 表示は mmap のまま(末尾へすぐ跳ぶ・任意の位置を覗く・追記を追う、には mmap が向いています)。
- 索引作りと全文検索だけ pread(4MB ずつ)に向けました。
| 操作(50GB) | 前(秒) | 後(秒) | klogg 24.11(秒) |
|---|---|---|---|
| 開く(索引ができるまで) | 100.6 | 50.44 | 52.55 |
| 検索(開いた後) | 88.9 | 53.50 | 55.59 |
klogg とは、開く・検索とも同等になりました(1.5 倍未満の差は「同等」と書きます)。約 2 倍負けていたところが並んだ、という言い方までが正確です。
一度、画面を固めています。pread は同期で返るので、UI スレッドで回すと、50GB なら 50 秒間、応答がなくなりました。背景のスレッドへ逃がして直し、「ヒットの通知が、呼び出し元と別のスレッドから来ること」を確かめるテストを入れました。秒数を見るテストではないので、結果がぶれません。
3. 改行の数え方を 1.88 倍速くしたのに、1 秒も縮まなかった(1 回目)
巨大なテキストを画面で扱うには、「何行目がファイルの何バイト目か」の目印が要り、作るには通しで改行(\n)を数えるしかありません。1 バイトずつ比べていた数え方を、Span.IndexOf で次の改行まで跳ぶ形に替えました。
| 数え方 | メモリ上(GB/s) | 50GB をディスクから(MB/s) |
|---|---|---|
1 バイトずつ == '\n' |
1.74 | 968 |
Span.IndexOf で跳ぶ |
3.27 | 969 |
| ベクタ命令(SIMD)で比べる | 17.9 | (入れていない) |
数えた行数は、どちらも 892,239,125 行で一致しました。メモリ上の 1.88 倍の差が、ディスクからは消えました。 バイトが届く速さが約 0.97GB/s しかないので、どちらの数え方も、届く速さより速い。余った能力は、待ち時間になるだけです。
2 章の「開く 100.6 秒 → 50.44 秒」は、同じ版に入ったこの変更の成果に見えます。違います。 ディスクから読む限り、1 バイトずつでも 968MB/s 出るので、主因は mmap → pread のほうでした。改善の成果を正しい原因に帰属させないと、次に同じ問題が起きたとき、また数え方を磨いてしまいます。
4. 2 回目(hot)では、改行の数え方が 4 割を占めていた
3 章の結論「改行の数え方は秒に出ない」は、1 回目(ディスクから読む)については今も正しい結論です。ところが、同じファイルを続けて探す 2 回目では、メモリ(ページキャッシュ)が媒体になります。ここで、無料版の検索コマンド uvf は、ripgrep より 1.3〜1.4 倍遅いままでした。
直す前に、時間の内訳を出す仕掛けを入れて、4 つの見立てを測りました(3GB・ヒットしない語・2 回目・5 回の中央値)。
| 見立て | 測ったこと | 3GB(秒) | 結果 |
|---|---|---|---|
| (前の版) | — | 0.40 | 内訳: 読む 0.13・探す 0.09・数える 0.15 |
| 行番号のために改行を全部数えている | 数えずに走らせる | 0.24 | 正解(数える分を抜くと ripgrep より速い) |
| ripgrep は mmap だから速い | こちらを mmap で読む | 0.43 | 外れ(遅くなる) |
| 4MB のブロックが大きすぎる | 256K〜16M に変える | 0.27〜0.30 | 外れ(大きさで変わらない) |
| 起動・後始末の固定分 | 空のファイルを探す | 0.02 | 外れ |
筆者がいちばん信じていたのは、「ripgrep は mmap で、コピーせずに読むから速い」でした。ところが、rg --no-mmap でも 0.29 秒で同じでした。もっともらしい話を、測る前に直していたら、遅くする改修を入れていたところです。
数え方は、16 バイトずつ改行と比べ、その結果をバイトのまま足し込み、255 回ごとにまとめて合計する形に替えました。3GB で 0.15 秒 → 0.028 秒(5 倍)です。
| 2 回目(秒・5 回の中央値) | 前 | 後 | ripgrep |
|---|---|---|---|
| 3GB・ヒットしない語 | 0.40 | 0.27 | 0.29 |
3GB・東京 |
0.40 | 0.27 | 0.30 |
| 10GB・ヒットしない語 | 1.28 | 0.85 | 0.95 |
10GB・東京 |
1.40 | 0.88 | 0.96 |
1 回目は変わりません(3GB 東京: 3.04 秒 → 3.03 秒)。出力は前後で 1 バイトも変わらず、行番号を含めて ripgrep と一致しています。差は 0.1 秒前後で、1.5 倍未満の「同等」の範囲です。50GB はメモリ(32GB)に収まらず、2 回目もディスクから読むので、この改修は効きません。
持ち帰れること
- 律速は、条件ごとに測り直す。 1 回目はディスク、2 回目はメモリ、50GB の 2 回目はまたディスク。同じコマンドでも、詰まる場所は入れ替わります。
- 上限に張り付いているかを、先に見る。 検索は mmap の上限 551MB/s に張り付いていたので、読み方を変えるしかありませんでした。
- 相手の「速い理由」を、推測で決めない。 「ripgrep は mmap だから速い」は、
rg --no-mmapを 1 回走らせれば確かめられることでした。 - ブロックサイズは、伸びなくなるところまで測る。 1MB → 4MB は効き、4MB → 16MB は効きませんでした。
- 速くしたら、答えが同じかを必ず確かめる。 9 億行の行数が 1 行もずれないこと、ripgrep と出力が一致することを、毎回突き合わせています。
自分で確かめるには
キャッシュを捨ててから、同じファイルに順に走らせます。キャッシュを捨てずに測ると、2 回目が速く出るだけで何も分かりません。
# 1 回目(既定の mmap)
rg --mmap -n -F '探す語' huge.log > /dev/null

# キャッシュを捨てる
#   macOS  : sudo purge
#   Linux  : sync && sudo sh -c 'echo 3 > /proc/sys/vm/drop_caches'
#   Windows: RAMMap64.exe -accepteula -Et (管理者権限)

# 2 回目(mmap を使わない)
rg --no-mmap -n -F '探す語' huge.log > /dev/null

# 媒体の素の帯域の目安(ブロックサイズを変えて)
dd if=huge.log of=/dev/null bs=1m count=20000
dd if=huge.log of=/dev/null bs=4m count=5000
出力の行数が、両方で一致することを必ず確かめてください。
負けているところ・注意
uvfは mmap を使わないので、3 つの OS で同じように動きます。その代わり、Linux の軽い検索で mmap が速い分は、取りこぼしています。- ripgrep が OS で違う理由は、推測です。
- 数字は、Mac(Apple M4・10 コア・メモリ 32GB・外付け USB SSD)の値が中心です。内蔵 NVMe など速い媒体では、mmap と pread の差、改行の数え方の差が変わるはずですが、測っていません。
- 筆者は、比較の一方の開発者です。その分は割り引いてお読みください。
関連
- ripgrep・grep と比べた全記録(このサイト)
- 「巨大ファイルが開けない」の答えのまとめ(このサイト)
- ripgrep は no-mmap で 2.9 倍速くなる(uvp.y42u.net)
- 画面が klogg に約 2 倍負けていた原因は mmap だった(uvp.y42u.net)
- 改行を 1.88 倍速く数えても、秒数は動かなかった(uvp.y42u.net)
- 改行の数え方が、2 回目の検索の 4 割を占めていた(uvp.y42u.net)
お願い
本記事の数値は筆者の環境での実測で、環境により変わります。誤りがありましたら、サポートのメールでお知らせください。確認のうえ修正します。
開発者より:アプリ・Kindle本・公開プロジェクトの一覧は GitHub: amru195704 にまとめています。

コメントを残す